Audit indépendant de l'« AI Grading Assistant » de Fobizz — l'étude d'Osnabrück relève des notes erratiques dans un outil sous licence dans des Länder allemands
Mühlhoff et Henningsen (Osnabrück) ont testé l'outil de notation par IA de Fobizz en deux séries : notes et retours semblaient arbitraires, un texte a varié de 1 à 14 points, et un suivi en 2026 sur deux autres outils a trouvé des variations similaires.
Détails
Promoteur
University of Osnabrück (Mühlhoff & Henningsen) — audit of Fobizz
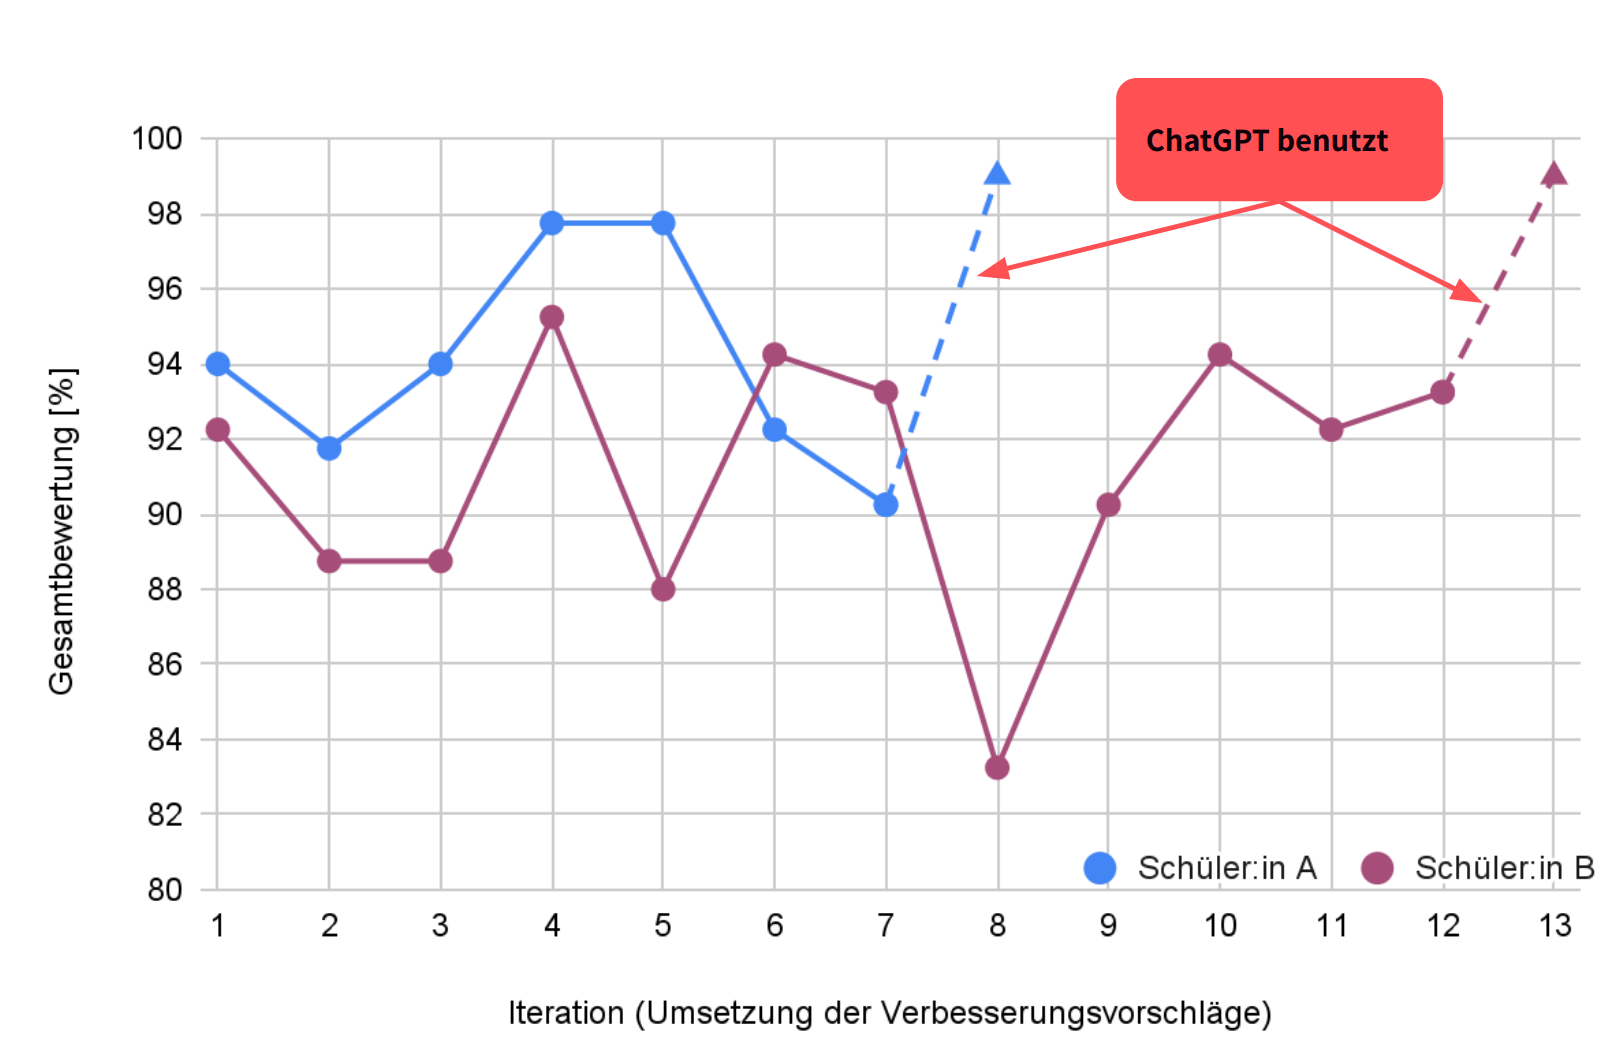
En décembre 2024, Rainer Mühlhoff et Marte Henningsen (Université d'Osnabrück) ont publié sur arXiv (2412.06651) et au 38e Chaos Communication Congress un test indépendant de l'« AI Grading Assistant » de l'entreprise allemande Fobizz, outil sous licence dans plusieurs Länder (Rhénanie-Palatinat, Mecklembourg-Poméranie-Occidentale, Saxe). Fobizz revendique plus de 500 000 enseignants dans plus de 7 500 écoles. Sur deux séries de tests, les auteurs ont constaté que les notes et les commentaires paraissaient souvent aléatoires et ne s'amélioraient pas de façon fiable en appliquant les suggestions de l'outil ; seuls les textes générés par ChatGPT obtenaient les meilleures notes ; les affirmations fausses et les textes absurdes passaient souvent inaperçus ; certains critères étaient appliqués de manière opaque. Dans l'exemple rapporté par heise, un même texte a reçu entre 1 et 14 points selon les exécutions. Les auteurs jugent trompeur le marketing « objectif et gain de temps » et demandent une évaluation systématique et pédagogique par discipline avant l'entrée de ces outils à l'école. Fobizz a ajusté son prompt après la publication sans partager l'original. Un suivi de 2026 (Mühlhoff et Quägwer, SEMINAR – Lehrerbildung und Schule 2/2026) a testé FelloFish et Edaira avec des textes simulés et a de nouveau relevé une forte variation pour des entrées identiques, une faible reproductibilité et une tendance à mieux noter la reprise littérale des suggestions ; ces outils ne devraient soutenir les enseignants que sous supervision humaine critique. Réserves : les études utilisent des textes simulés et ne mesurent pas les acquis ; le nombre exact de textes et d'exécutions figure dans les annexes et n'a pas été revérifié. Un petit pilote indépendant (IADIS) montre que trois enseignants expérimentés ont aussi modifié au moins une note entre deux tours dans 73 % des cas : la notation humaine n'est pas un étalon parfait. La pratique enregistrée est l'audit lui-même : une méthode ouverte et reproductible pour tester les outils d'évaluation par IA avant achat.
Mise en œuvre
Les détails de mise en œuvre (coût, calendrier, personnel, conditions de réussite) ne sont pas encore disponibles pour cette pratique.
Vous portez cette pratique ?
Revendiquez-la —
les porteurs vérifiés obtiennent un contact public sur la page et peuvent proposer des corrections.
Sources de données
D'où proviennent les informations de cette pratique, et quand.