Auditoria independente ao «AI Grading Assistant» da Fobizz — estudo de Osnabrück encontra notas erráticas numa ferramenta licenciada por estados alemães
Mühlhoff e Henningsen (Osnabrück) testaram a ferramenta de classificação por IA da Fobizz em duas séries de testes: notas e feedback pareciam arbitrários, um texto variou entre 1 e 14 pontos e um estudo de 2026 com outras duas ferramentas encontrou variação semelhante.
Detalhes
Promotor
University of Osnabrück (Mühlhoff & Henningsen) — audit of Fobizz
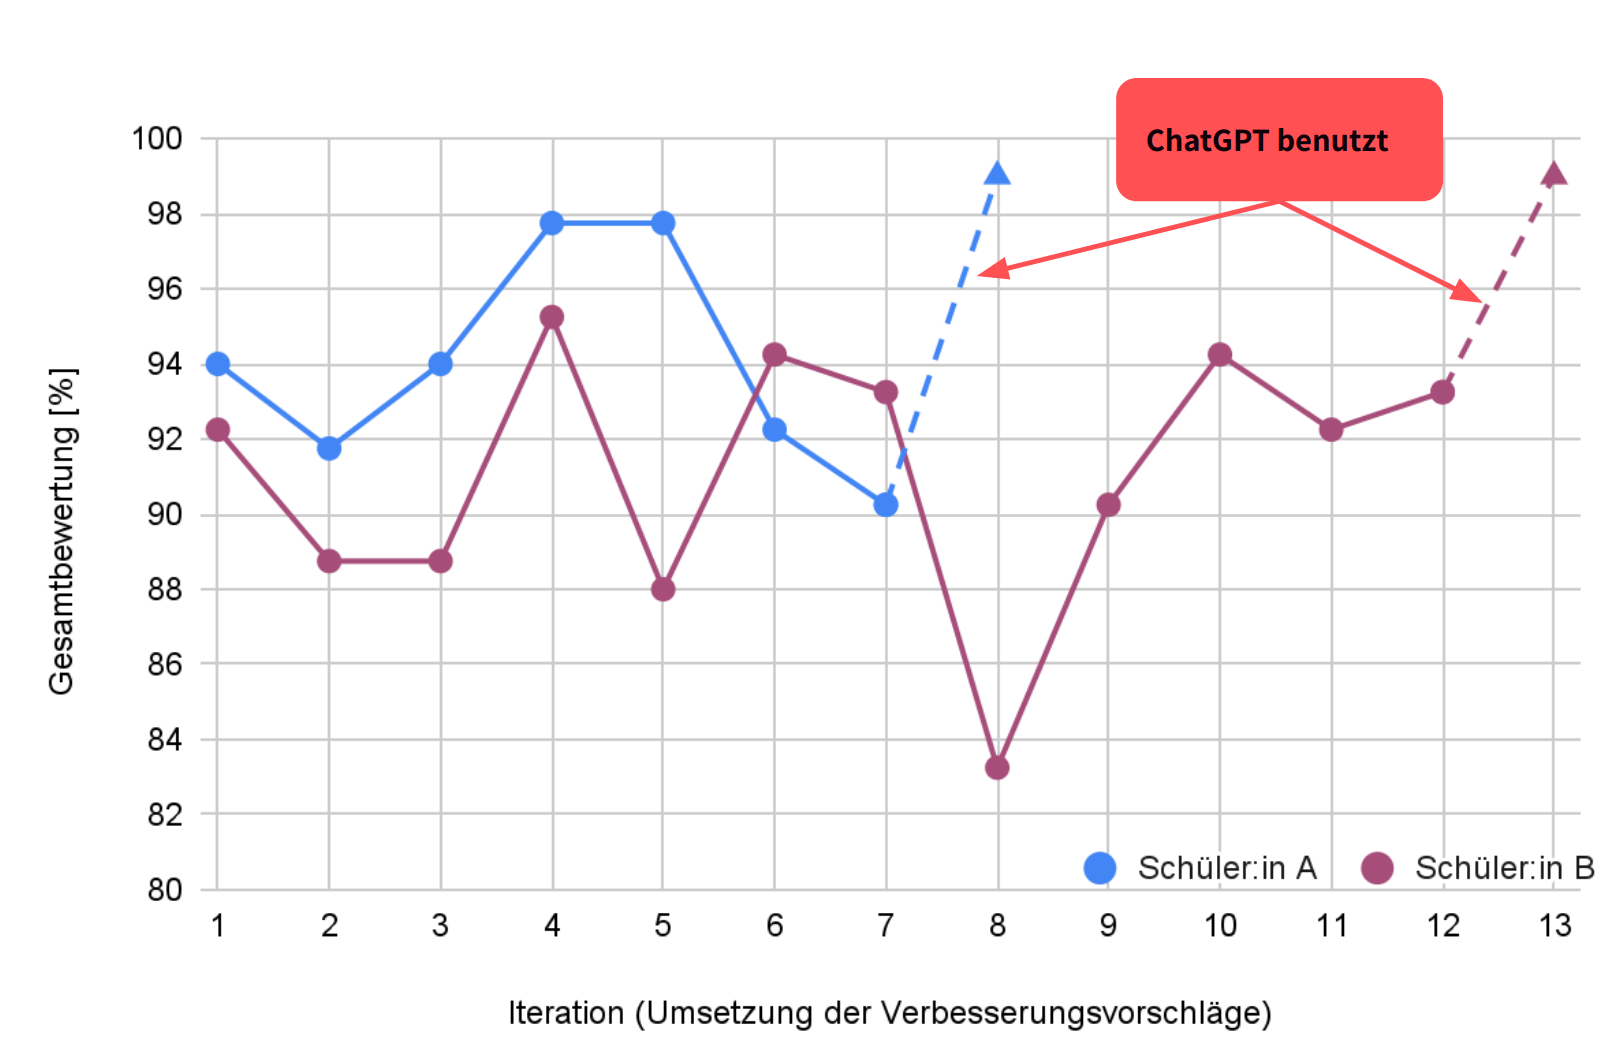
Em dezembro de 2024, Rainer Mühlhoff e Marte Henningsen (Universidade de Osnabrück) publicaram no arXiv (2412.06651) e no 38.º Chaos Communication Congress um teste independente ao «AI Grading Assistant» da empresa alemã Fobizz, ferramenta licenciada a escolas de vários estados alemães (Renânia-Palatinado, Mecklemburgo-Pomerânia Ocidental, Saxónia). A própria Fobizz refere mais de 500 000 professores em mais de 7500 escolas. Em duas séries de testes, os autores concluíram que as notas e o feedback escrito pareciam muitas vezes aleatórios e não melhoravam de forma fiável ao aplicar as sugestões da ferramenta; só os textos gerados pelo ChatGPT obtiveram as classificações máximas; afirmações falsas e textos sem sentido passavam muitas vezes despercebidos; e alguns critérios eram aplicados de forma opaca. No exemplo relatado pela heise, um único texto recebeu entre 1 e 14 pontos em execuções repetidas. Os autores consideram enganador o marketing «objetivo e que poupa tempo» e pedem uma avaliação sistemática e pedagógica por disciplina antes de estas ferramentas chegarem às escolas. A Fobizz ajustou o prompt após a publicação, mas não partilhou o original. Um estudo de seguimento de 2026 (Mühlhoff e Quägwer, SEMINAR – Lehrerbildung und Schule 2/2026) testou FelloFish e Edaira com textos simulados e voltou a encontrar variação considerável com entradas idênticas, fraca reprodutibilidade e tendência para premiar a adoção literal das sugestões; concluem que estas ferramentas só devem apoiar os professores sob supervisão humana crítica. Ressalvas: os estudos usam textos simulados e não medem resultados de aprendizagem; o número exato de textos e execuções consta dos apêndices e não foi reverificado de forma independente. Um pequeno piloto independente (IADIS) mostrou que três professores experientes também alteraram pelo menos uma nota entre rondas em 73% dos casos, pelo que a classificação humana não é um padrão perfeito. A prática registada é a própria auditoria: um método aberto e replicável para testar ferramentas de avaliação com IA antes da aquisição.
Implementação
Os detalhes de implementação (custo, prazo, equipa, condições de sucesso) ainda não estão disponíveis para esta prática.
Implementa esta prática?
Reivindique-a —
implementadores verificados obtêm um contacto público na página e podem propor correções.
Fontes de dados
De onde foi obtida a informação desta prática, e quando.