Auditoría independiente del «AI Grading Assistant» de Fobizz — un estudio de Osnabrück halla calificaciones erráticas en una herramienta con licencia en estados alemanes
Mühlhoff y Henningsen (Osnabrück) probaron la herramienta de calificación con IA de Fobizz en dos series: notas y comentarios parecían arbitrarios, un texto varió de 1 a 14 puntos y un seguimiento de 2026 con otras dos herramientas halló variación similar.
Detalles
Promotor
University of Osnabrück (Mühlhoff & Henningsen) — audit of Fobizz
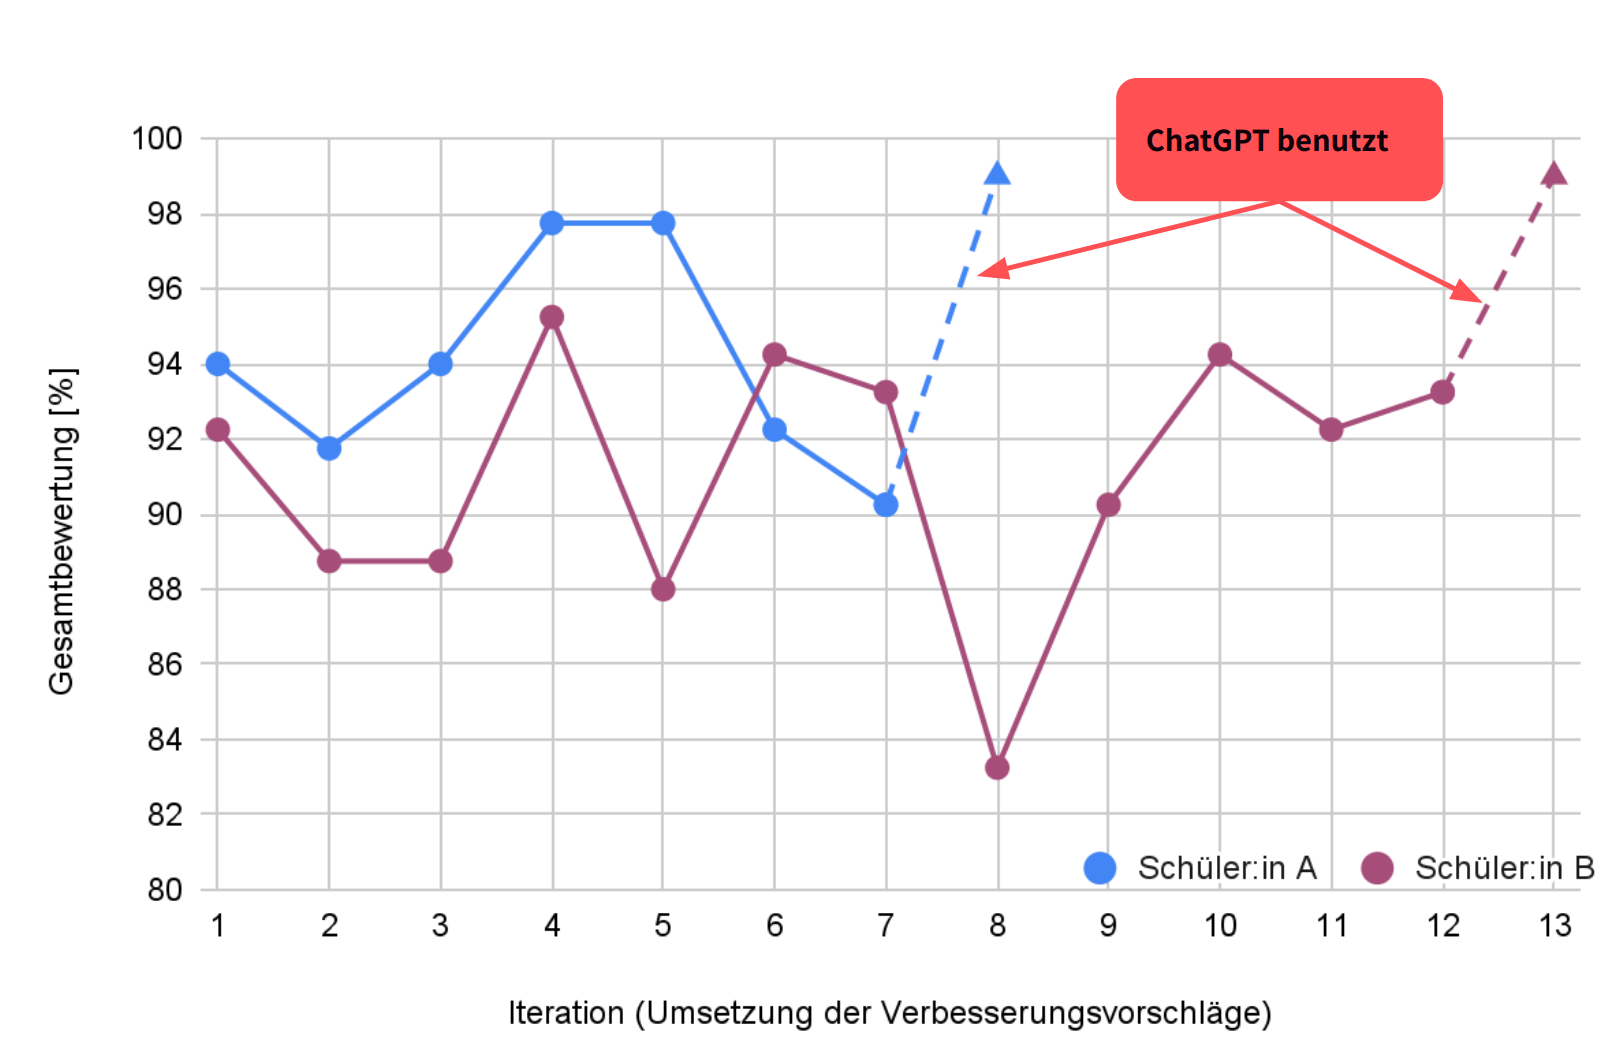
En diciembre de 2024, Rainer Mühlhoff y Marte Henningsen (Universidad de Osnabrück) publicaron en arXiv (2412.06651) y en el 38.º Chaos Communication Congress una prueba independiente del «AI Grading Assistant» de la empresa alemana Fobizz, herramienta con licencia en escuelas de varios estados alemanes (Renania-Palatinado, Mecklemburgo-Pomerania Occidental, Sajonia). La propia Fobizz afirma tener más de 500 000 docentes en más de 7500 escuelas. En dos series de pruebas, los autores hallaron que las notas y los comentarios parecían a menudo aleatorios y no mejoraban de forma fiable al aplicar las sugerencias de la herramienta; solo los textos generados por ChatGPT recibieron las máximas puntuaciones; las afirmaciones falsas y los textos sin sentido pasaban con frecuencia inadvertidos; y algunos criterios se aplicaban de forma opaca. En el ejemplo recogido por heise, un mismo texto recibió entre 1 y 14 puntos en ejecuciones repetidas. Los autores consideran engañoso el marketing «objetivo y que ahorra tiempo» y piden una evaluación sistemática y pedagógica por materia antes de que estas herramientas lleguen a las aulas. Fobizz ajustó su prompt tras la publicación, pero no compartió el original. Un seguimiento de 2026 (Mühlhoff y Quägwer, SEMINAR – Lehrerbildung und Schule 2/2026) probó FelloFish y Edaira con textos simulados y volvió a encontrar gran variación con entradas idénticas, escasa reproducibilidad y tendencia a premiar la adopción literal de las sugerencias; concluyen que estas herramientas solo deben apoyar al profesorado bajo supervisión humana crítica. Salvedades: los estudios usan textos simulados y no miden resultados de aprendizaje; el número exacto de textos y ejecuciones consta en los apéndices y no se reverificó de forma independiente. Un pequeño piloto independiente (IADIS) mostró que tres docentes experimentados también cambiaron al menos una nota entre rondas en el 73 % de los casos, por lo que la calificación humana no es un patrón perfecto. La práctica registrada es la propia auditoría: un método abierto y replicable para probar herramientas de evaluación con IA antes de adquirirlas.
Implementación
Los detalles de implementación (coste, plazo, personal, condiciones para el éxito) aún no están disponibles para esta práctica.
¿Usted implementa esta práctica?
Reivindíquela —
los implementadores verificados obtienen un contacto público en la página y pueden proponer correcciones.
Fuentes de datos
De dónde se obtuvo la información de esta práctica, y cuándo.